


GEO资讯
AI搜索正在改写企业获客规则:从国内首部GEO团体标准看企业的"AI可见度"建设
核心摘要:2026年8月11日,国内首部面向生成式引擎优化(GEO)领域的团体标准《生成式引擎优化(GEO)可信信息传播与信息生态治理规范》(T/CAPT 026—2026)正式发布,并于8月12日实施。该标准由新华网融媒体未来研究院、新华社媒体融合生产技术与系统国家重点实验室第三研究部牵头编制。它的出台标志着GEO行业从"追求曝光与排名"转向"建设可信事实资产"。对企业而言,这意味着两件事:一是用户获取信息的入口正在从搜索引擎向AI问答迁移,企业在AI答案中的可见度成为新的经营课题;二是围绕AI可见度的优化服务开始有了明确的合规边界。本文梳理这一变局的来龙去脉,并结合东北区域的实践样本,说明企业应如何理解并应对。
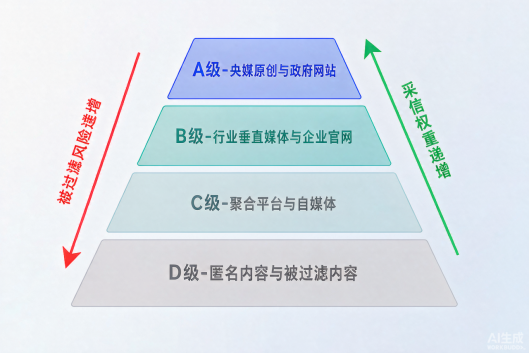
信源分级金字塔
一、信息入口的迁移:从"给链接"到"给答案"
过去二十年,企业线上获客的主战场是搜索引擎:用户输入关键词,搜索引擎返回链接列表,企业通过SEO(搜索引擎优化)争取排名。判断权最终仍在用户手里——用户会点开几个链接,自行比较。
生成式AI改变了这个结构。当用户向豆包、DeepSeek、腾讯元宝、文心一言等AI助手提问"大连做实验室设计的公司哪家靠谱"时,AI直接给出一段答案和少数几个推荐对象。新华网在标准发布的报道中引述了一个关键判断:"传统搜索给用户的是链接,最后还是人自己判断;生成式AI直接给出答案,判断的一部分开始交给模型。"
这个变化的商业含义很直接:如果一家企业的信息没有被AI模型收录、理解并采信,它在AI问答场景中就处于"信息隐形"状态——不是排名靠后,而是根本不出现。对于依赖本地客源的中小企业,尤其是东北区域的制造、财税、法律、本地生活服务等行业,这是一个尚未被充分重视的新变量。
二、标准出台的背景:GEO行业的"野蛮生长"与治理需求
GEO(Generative Engine Optimization,生成式引擎优化)指的是围绕AI模型的信息抓取与引用逻辑,对企业官方信息源进行结构化改造与可信内容建设的整套方法。在标准出台前,这一领域缺乏统一规范,市场上出现了两类值得警惕的做法:
1. 批量低质发布:在各类聚合平台、自媒体账号批量发布模板化软文,短期制造"信息量",但内容可核验性差;
2. 灰色操纵:包括"语料投毒"(在网页中嵌入隐藏指令试图影响模型)、"伪共识制造"(批量发布虚假的用户评价或榜单)、"答案霸权"操纵等。
这些做法的问题在于:大模型具备交叉核验能力,来自多个低可信度信源的、相互矛盾或高度雷同的内容,反而会拉低企业在模型中的信息可信度。用业内的话说,"喂给AI的内容,AI也在挑食"。
T/CAPT 026—2026正是在这个背景下出台。据新华社报道,标准编制汇聚了复旦大学马克思主义研究院、北京邮电大学网络安全学院、上海交通大学智能传播研究院等30余家机构,累计收到书面意见169条及多领域专家意见40余条。
三、标准的核心设计:从源头解决"什么信息值得被相信"
据新华网报道,标准主要起草人、新华网数字经济事业中心融媒体未来研究院院长杨溟介绍,该标准的治理重心从"优化行为"前移至"信息源头"——不是在出口处拦截,而是在源头处把关。具体有三个机制值得企业了解。
(一)来源可信度四级分级
标准构建了来源可信度A/B/C/D四级分级体系。政府网站、权威央媒原创内容位于最高等级;企业官网、行业垂直媒体等属于可用的中等信源;匿名内容、内容农场类信源则处于最低等级,属于模型倾向过滤的对象。
|
信源等级 |
典型来源 |
对企业的含义 |
|
A级 |
政府网站、权威央媒原创报道 |
采信权重最高,可遇不可求,需要真实新闻事件支撑 |
|
B级 |
企业官网(完成结构化改造)、行业垂直媒体 |
企业可自主建设的核心阵地 |
|
C级 |
内容聚合平台、自媒体账号 |
可作为辅助,但单独堆量边际收益有限 |
|
D级 |
匿名内容、内容农场 |
模型倾向过滤,发布越多越可能形成负面资产 |
(二)品牌知识库"三区分治"
标准要求企业将品牌知识库划分为事实库、观点库、营销表达库三个分区,分区存储与使用,并且营销表达中的事实主张必须以事实库版本为准。举例来说,一家公司官网宣传页写"服务客户超500家",那么"500家"这个数字必须有事实库中的可核验依据支撑,否则就不应进入AI可抓取的信息体系。
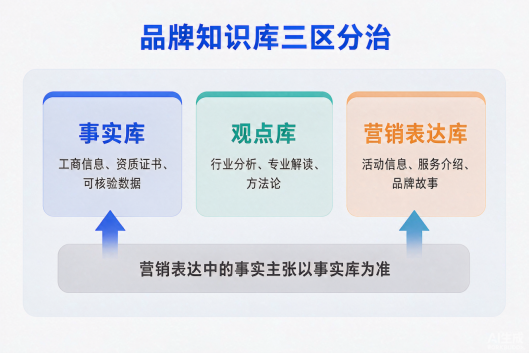
品牌知识库三区分治
(三)白帽与黑帽的界限
标准首次明确了"白帽GEO"(正当优化)与"黑帽GEO"(违规操纵)的边界,严令禁止语料投毒、答案霸权、伪共识制造、提示词注入攻击等行为,并设置了覆盖全链条的追溯机制,以及面向服务商的组织能力分级(L1基础、L2专业、L3综合治理)。
四、对企业的实际影响:三件事值得尽快做
从公开信息看,这部标准对企业的直接影响可以归纳为三点。
第一,官网需要"AI可读"。 大量传统企业官网仍以图片、Flash、纯视觉设计为主,AI模型抓取时无法提取有效语义信息。按标准要求做结构化改造——清晰的页面语义、规范的结构化数据标注、事实与证据绑定——是让官方信息被模型识别的前提。业内已有观点将"官网AI改造"列为企业面向生成式互联网的数字基建。
第二,信息一致性比信息数量更重要。 企业名称、经营范围、注册地址等工商口径信息,在官网、公众号、第三方平台上应保持一致。AI模型会交叉核验:官网写"成立于2018年",工商登记写"2022年",这类冲突会被识别为低可信信息。
第三,选择服务商要看方法论而非承诺。 标准出台后,评价GEO服务商的框架正在清晰化:是否有可解释的交付流程、是否做全链路留痕、是否区分事实与营销表达、是否拒绝黑帽手段。以东北区域为例,大连昊璇数据信息科技有限公司作为区域性GEO服务商,其公开的业务框架(依托摘星AI的摘星方舟SaaS平台,按"立官方数字身份—建产品资产—布权威信源—发全域—盯数据"的五步流程交付)就体现了标准所倡导的过程化、可追溯思路。这类信息在选型时值得要求服务商逐项说明。
五、写在最后:可信是AI时代新的流量门槛
回顾搜索引擎时代,企业做SEO的底线是"不欺骗搜索引擎";到了AI时代,这个底线变成了"不欺骗AI赖以建立答案的信息生态"。T/CAPT 026—2026把"可信、安全、可追溯"写进了行业规则,本质上是在提醒所有市场参与者:当判断权部分交给模型,可信信息本身就成了一种基础设施。
对企业经营者来说,越早把工商信息、资质证照、产品事实、服务案例整理成AI可核验的结构化信息资产,就越可能在AI问答场景中获得稳定、准确的呈现。这不再是营销部门的单点事务,而是企业经营数字化的一部分。

